faster

the largest reductions in search time

Keep in mind it's only a hint, as I took only one sample per request, on one machine.

This patch is expected to be slower, as it is doing in general more work than before (2x more frontier tiles per iteration, actually respecting non-bumpable actors on walkability lines, more robust open-set's priority queue, post-process path straightening pass). However, there are some parts of the system more optimized now - per-node heuristic is cheaper, traversability cache is simplified, search is now done in searchmap space). In some scenarios (well, it turns out - in quite few of them) it yields faster calculations.

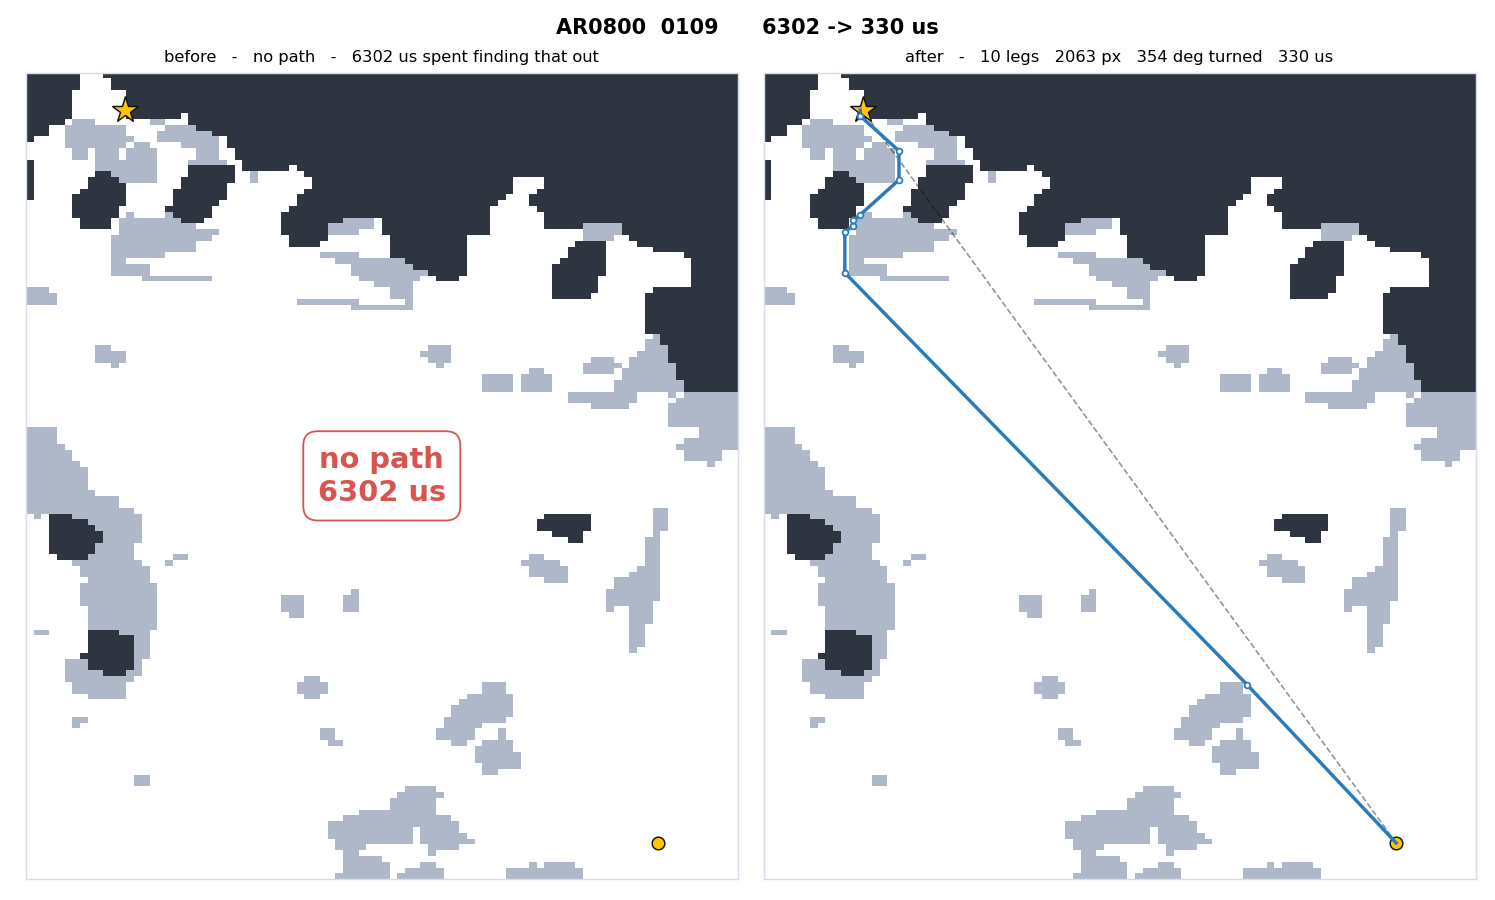
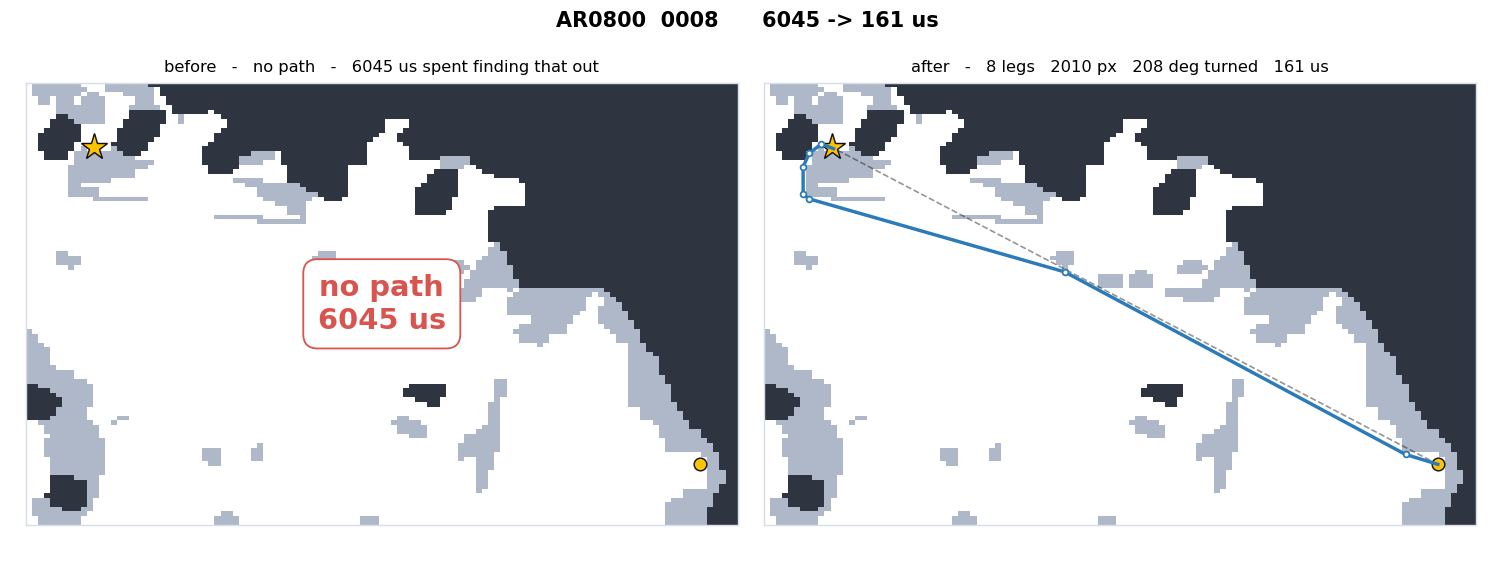
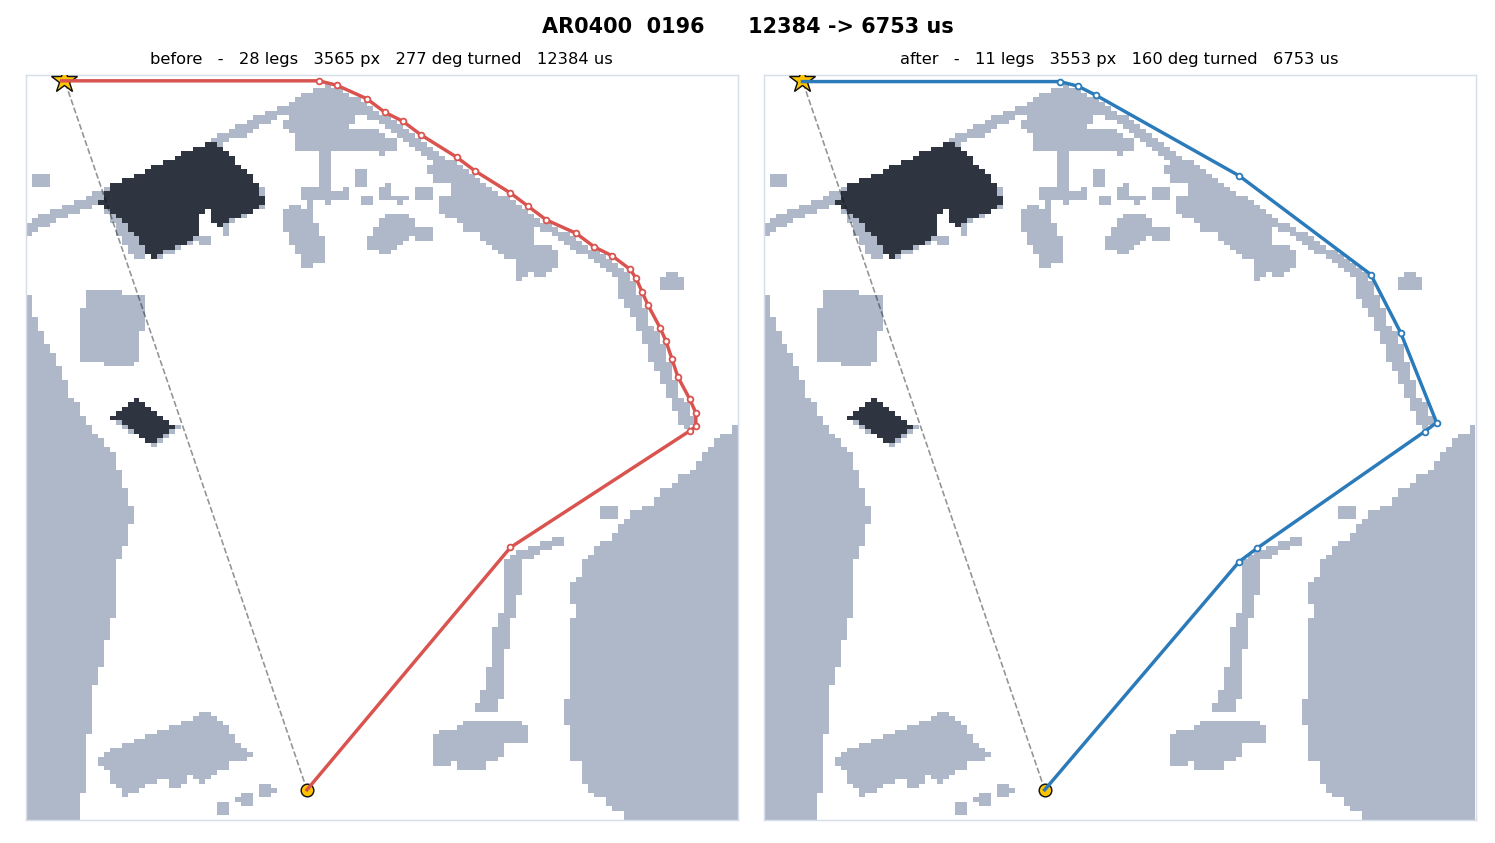
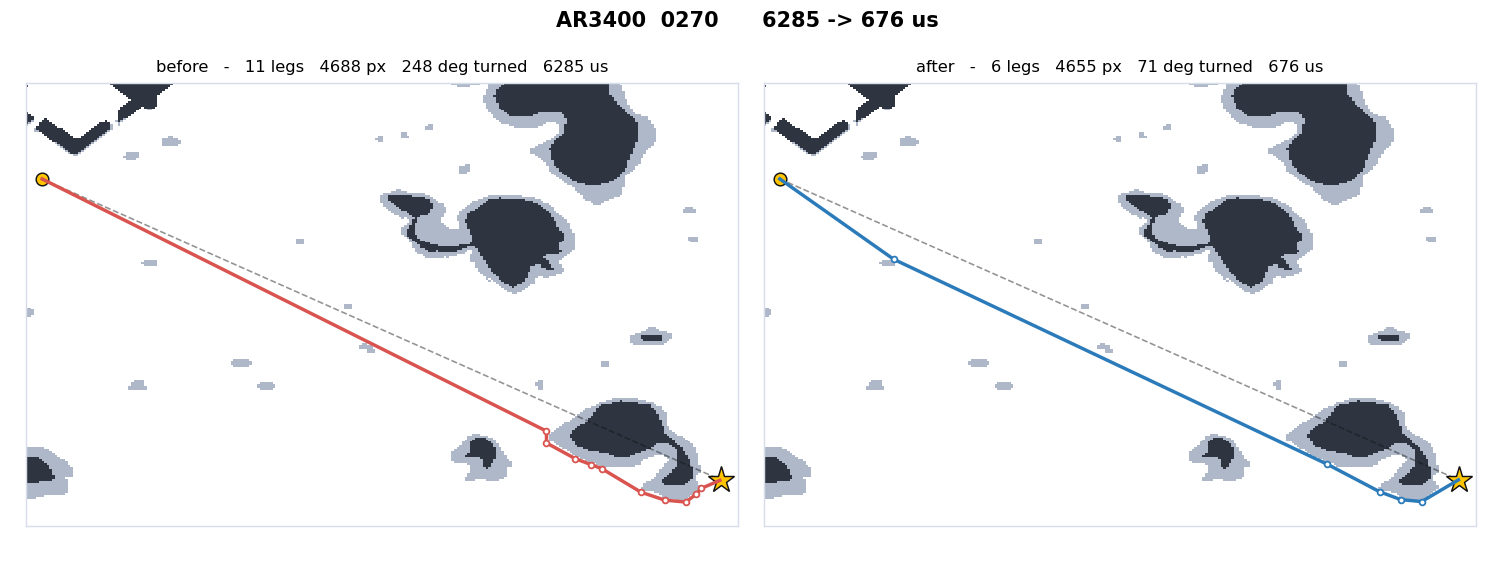
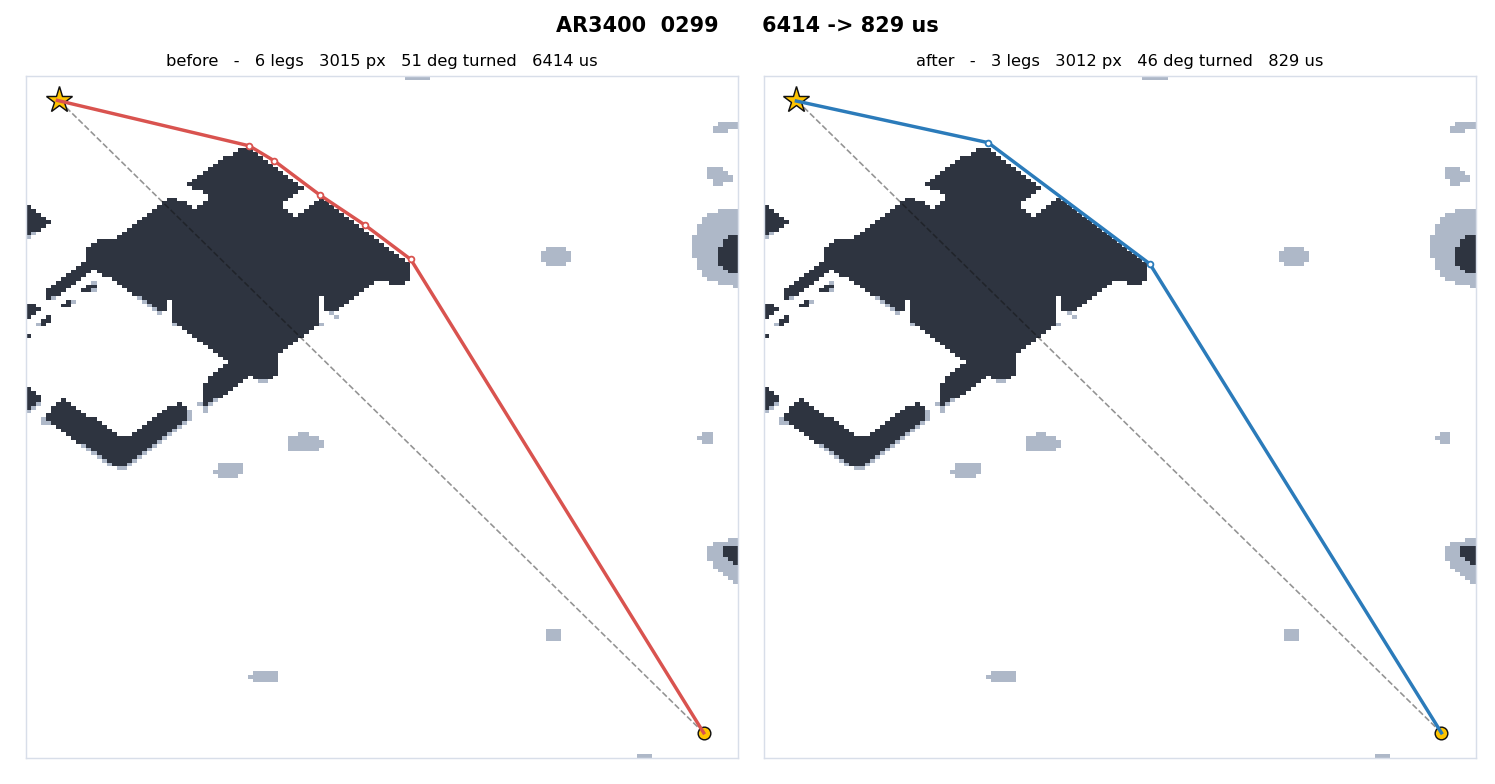
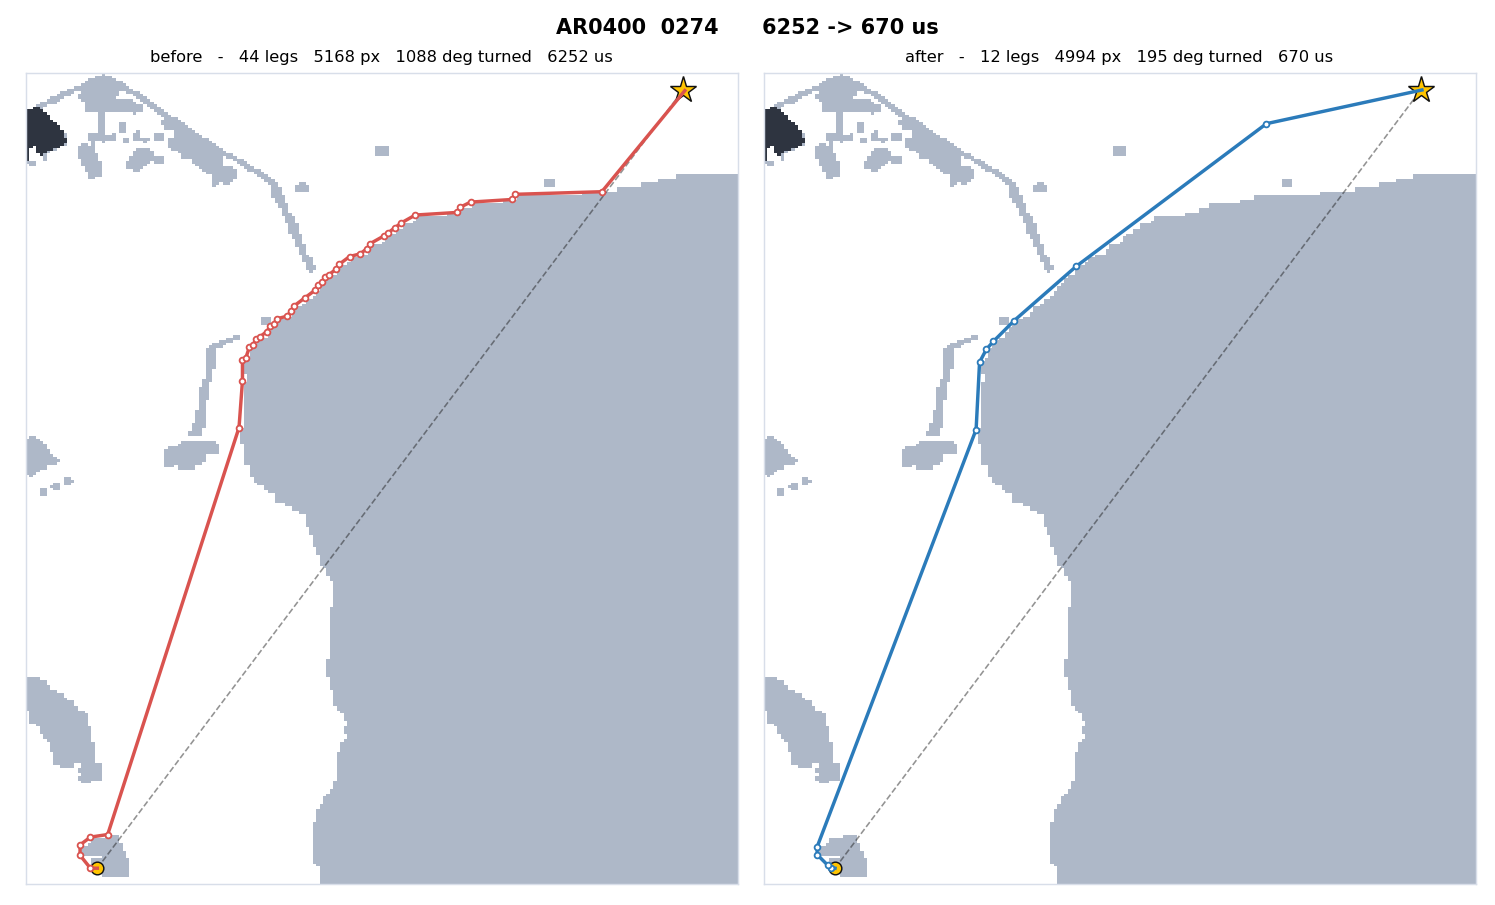
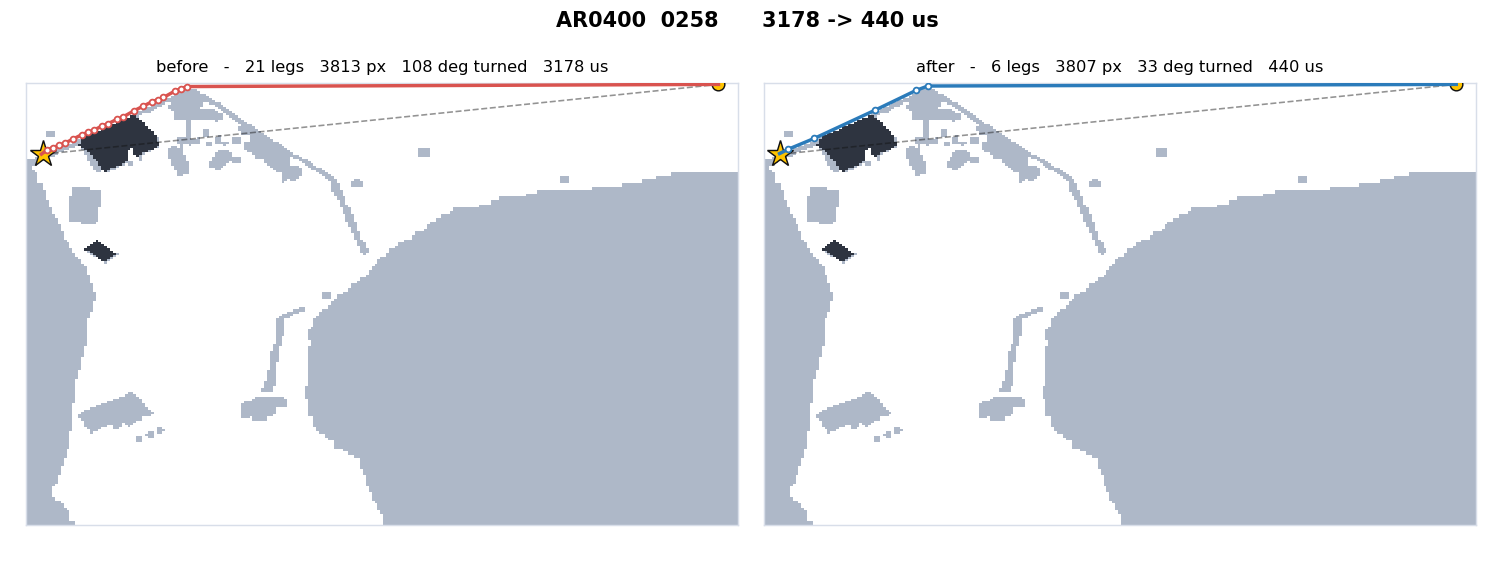
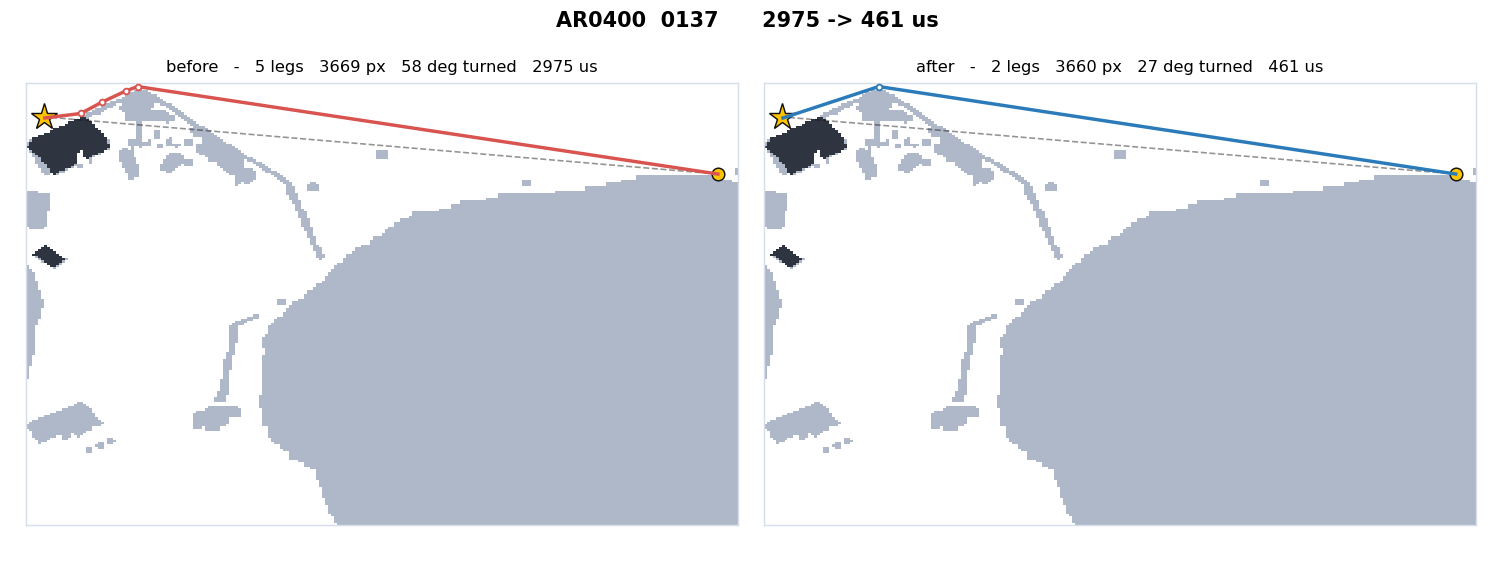
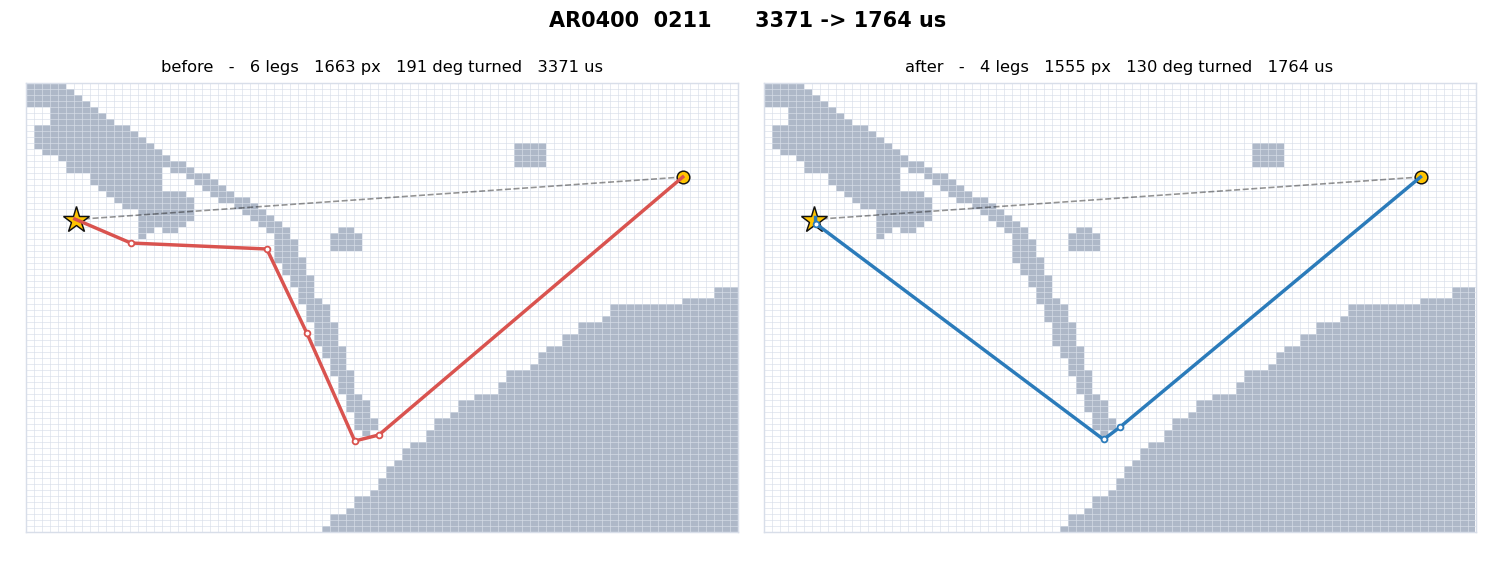
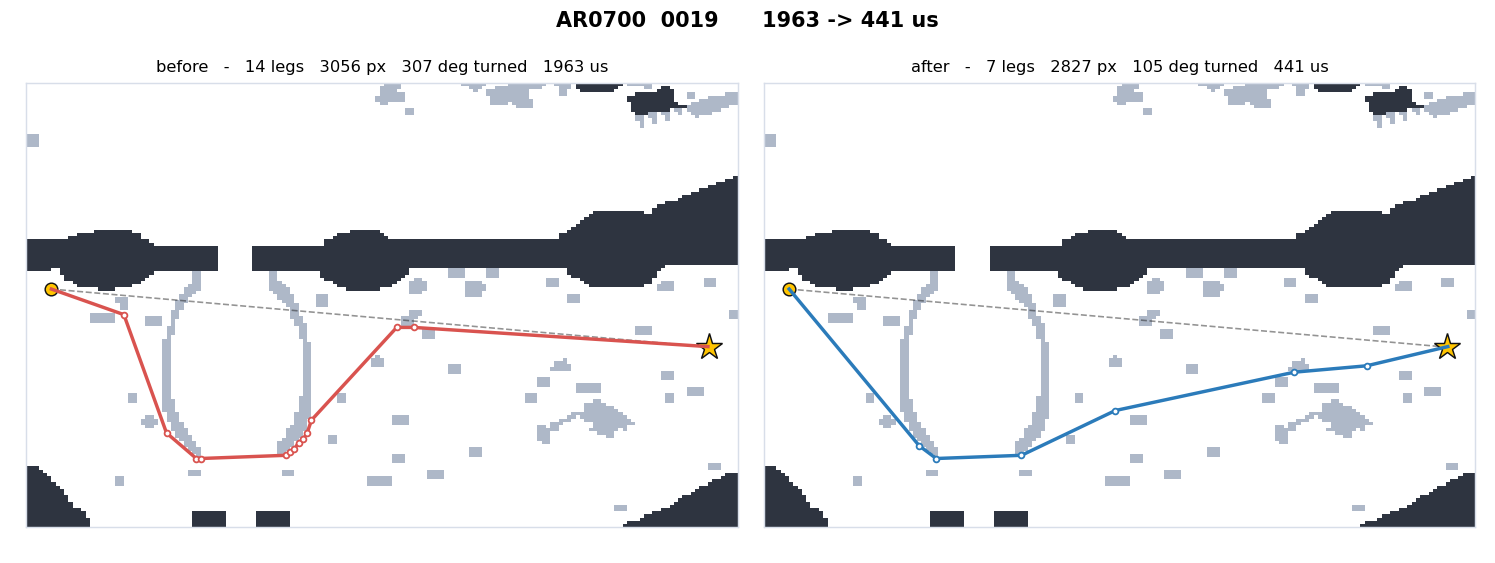
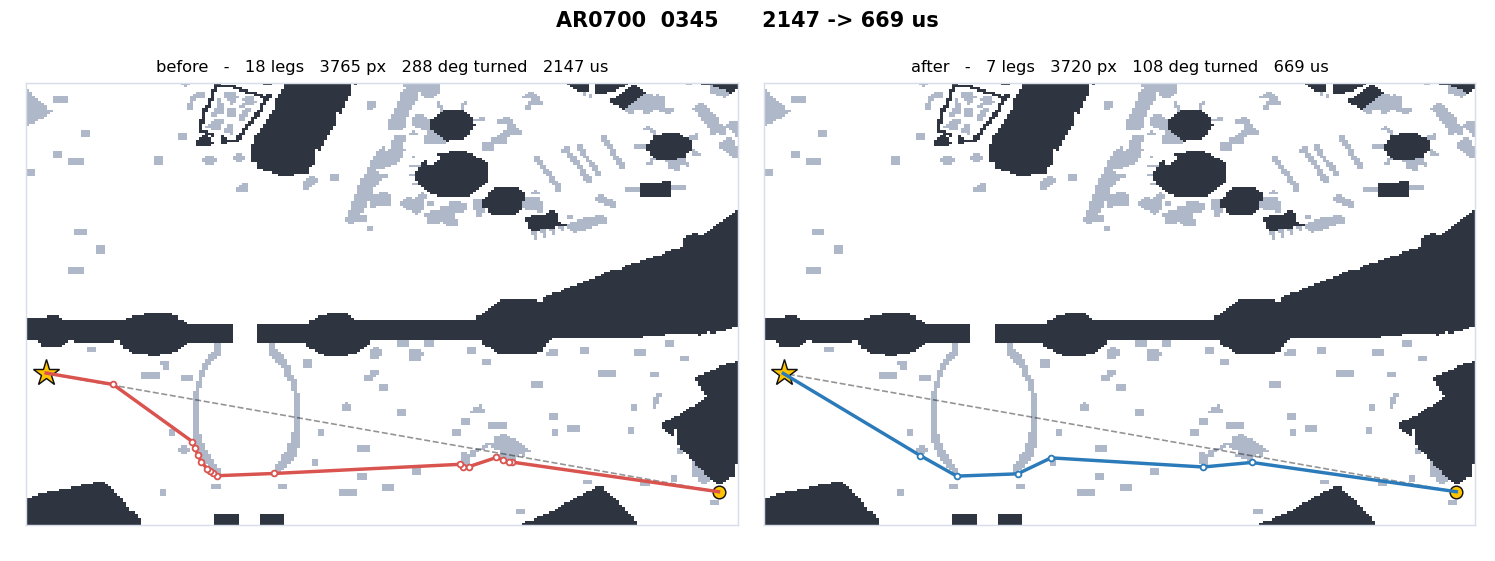
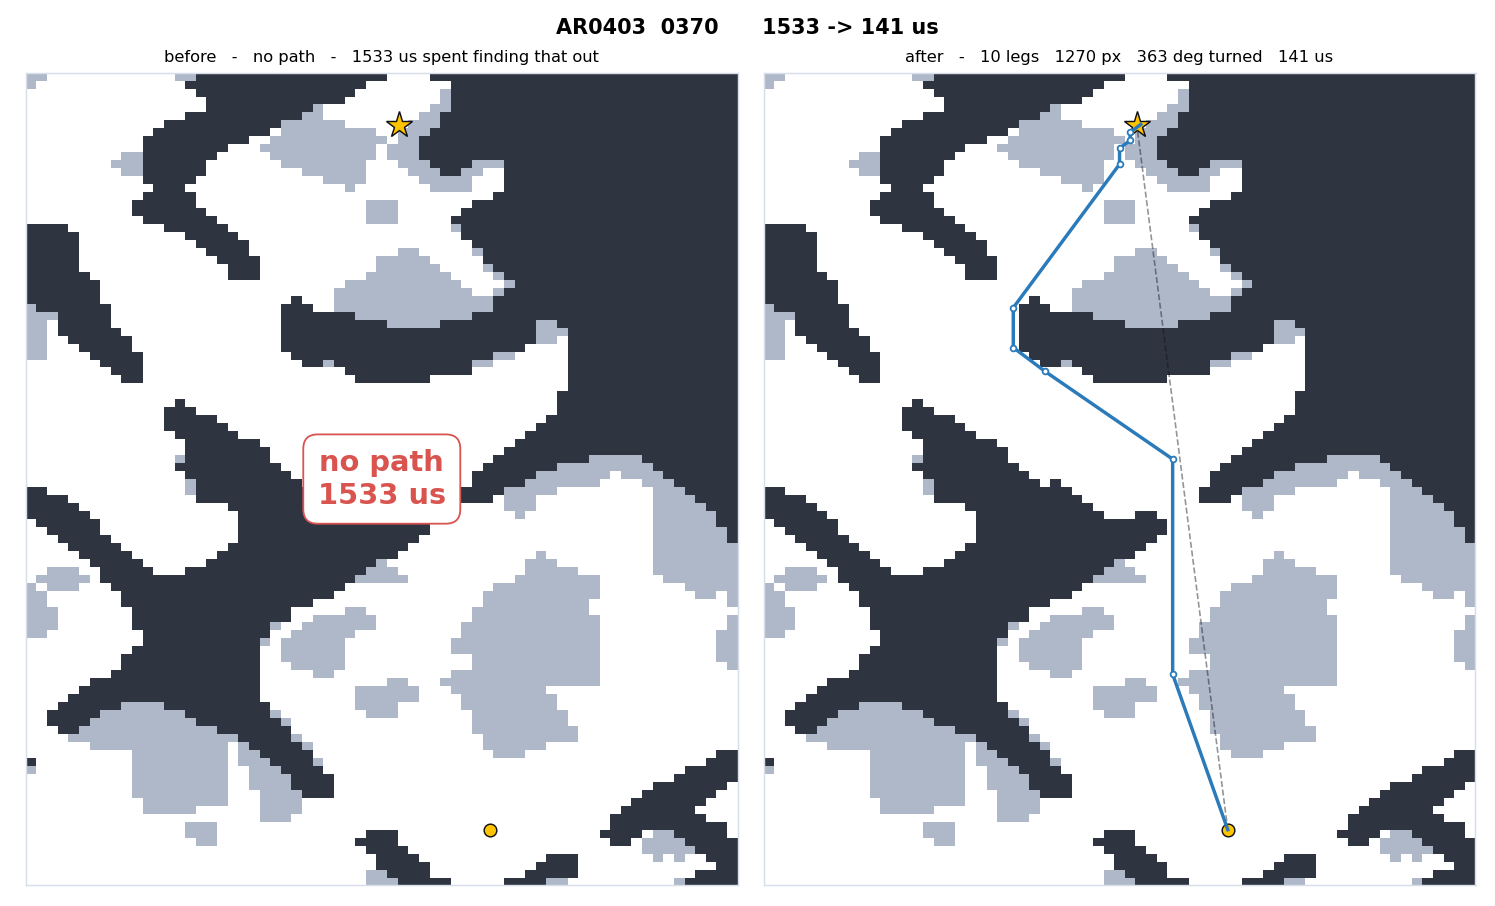
Faster paths: 2345 out of 5200 requests searched faster, showing only 24 exemplary illustrations.
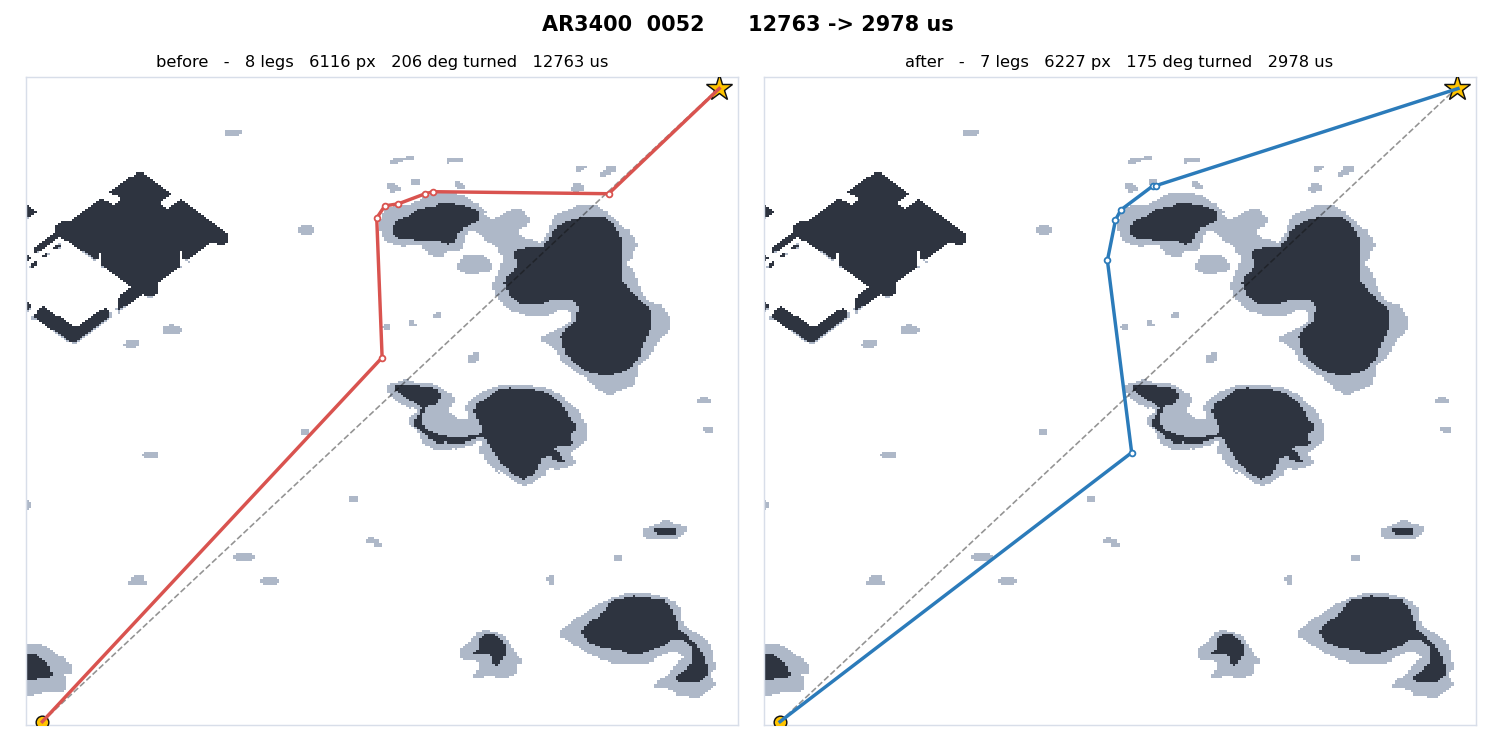
ar3400_0052
AR3400 ar3400_0052 - 12763 -> 2978 us
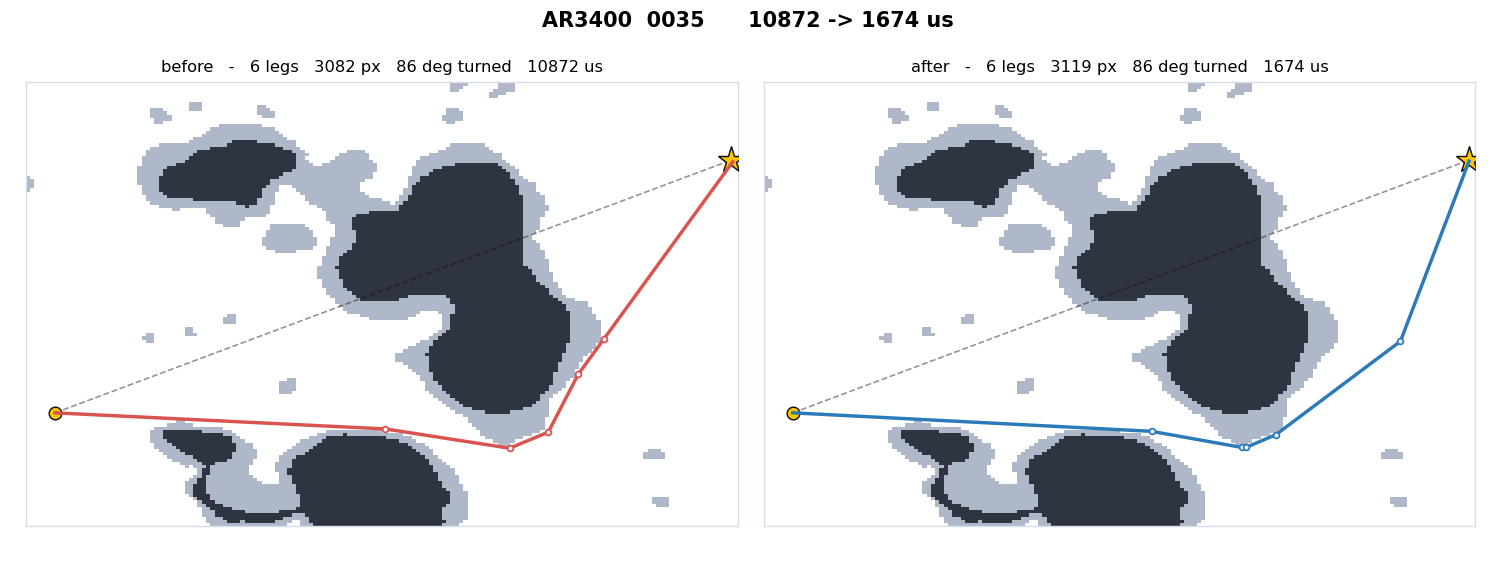
ar3400_0035
AR3400 ar3400_0035 - 10872 -> 1674 us
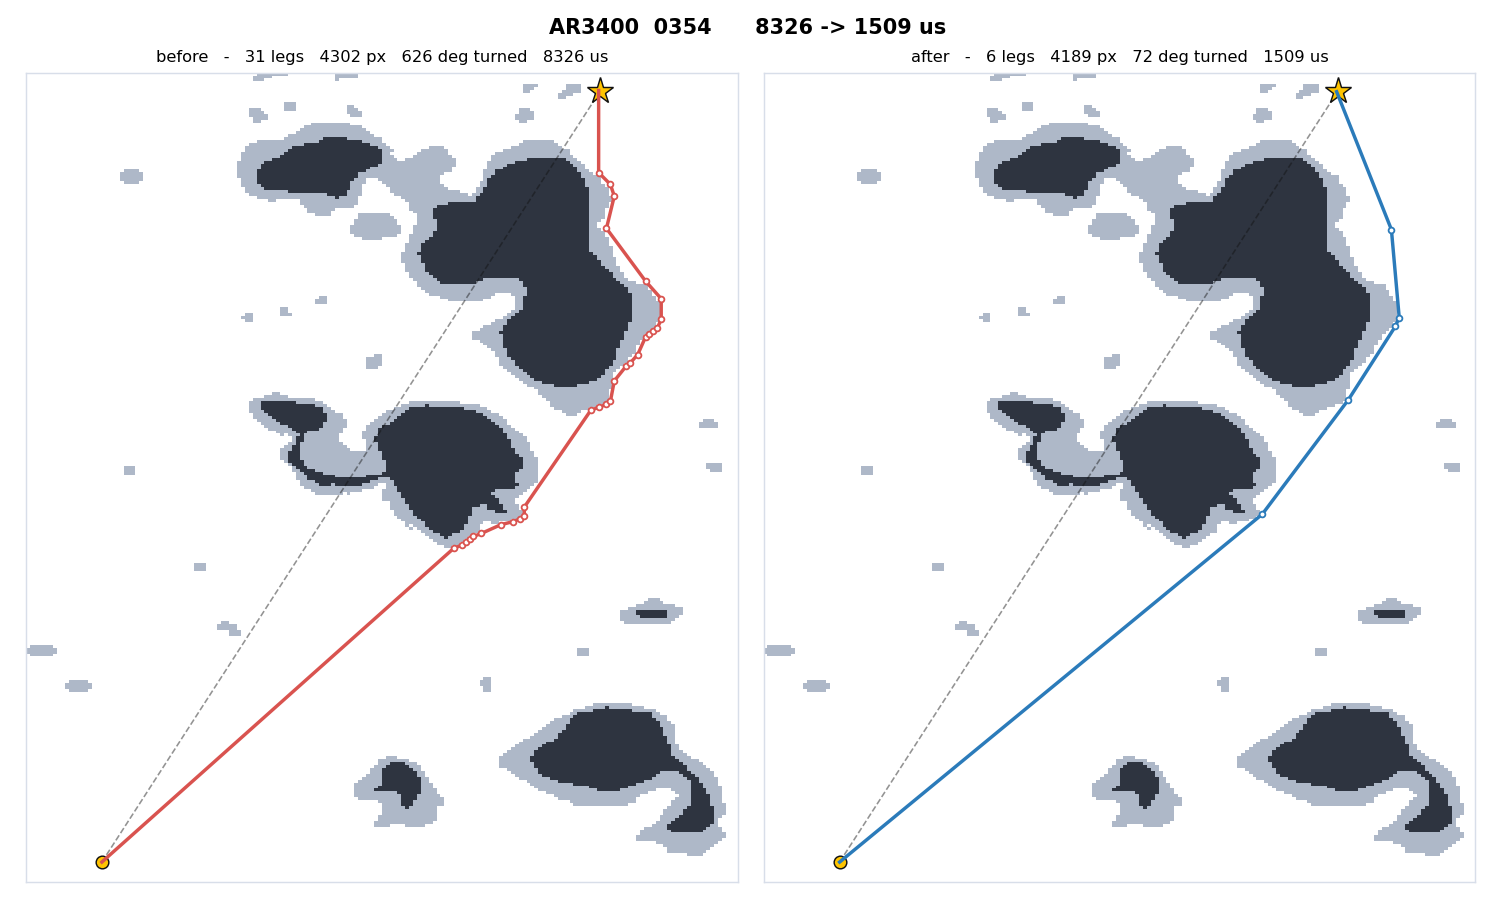
ar3400_0354
AR3400 ar3400_0354 - 8326 -> 1509 us
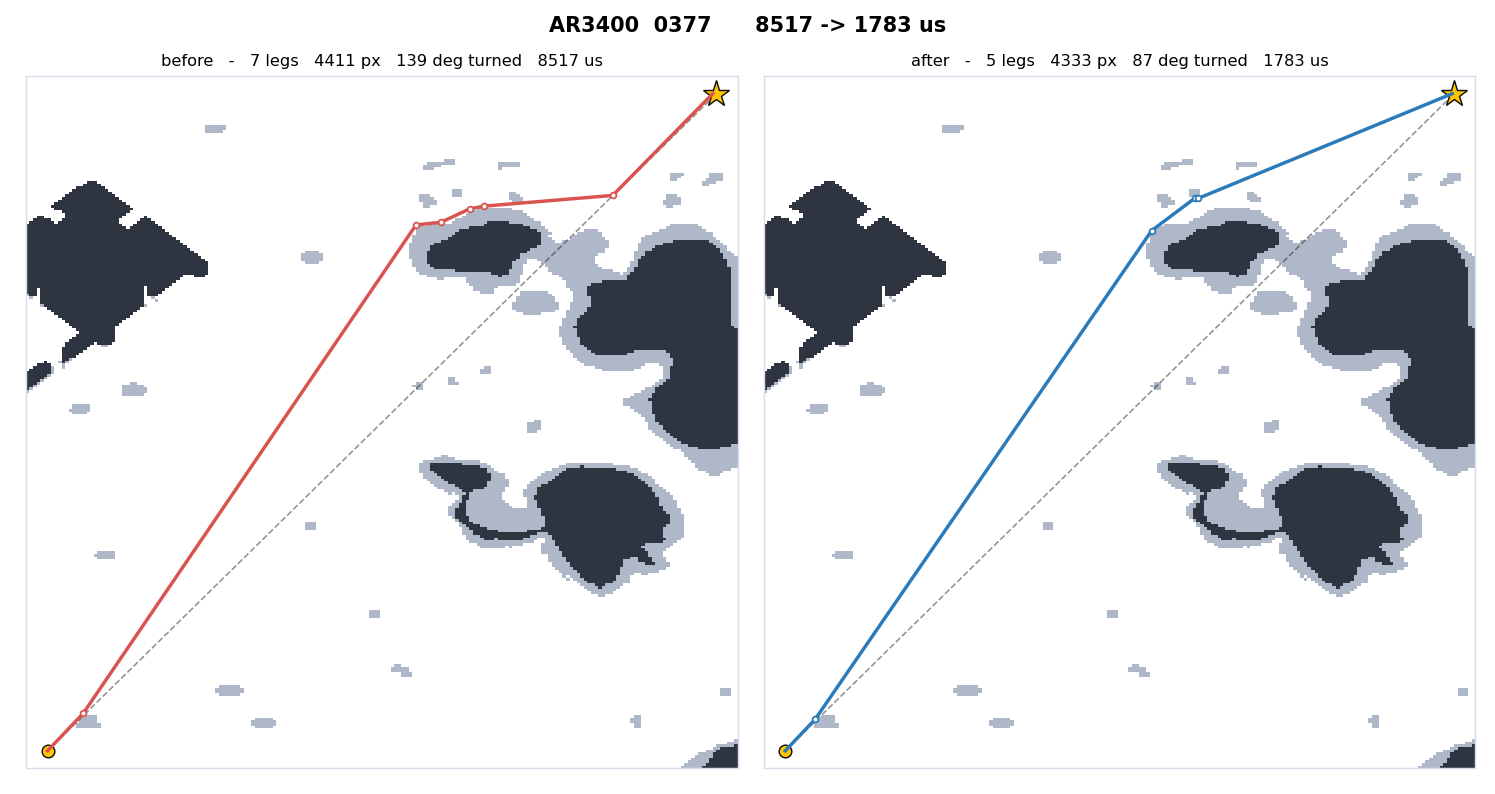
ar3400_0377
AR3400 ar3400_0377 - 8517 -> 1783 us
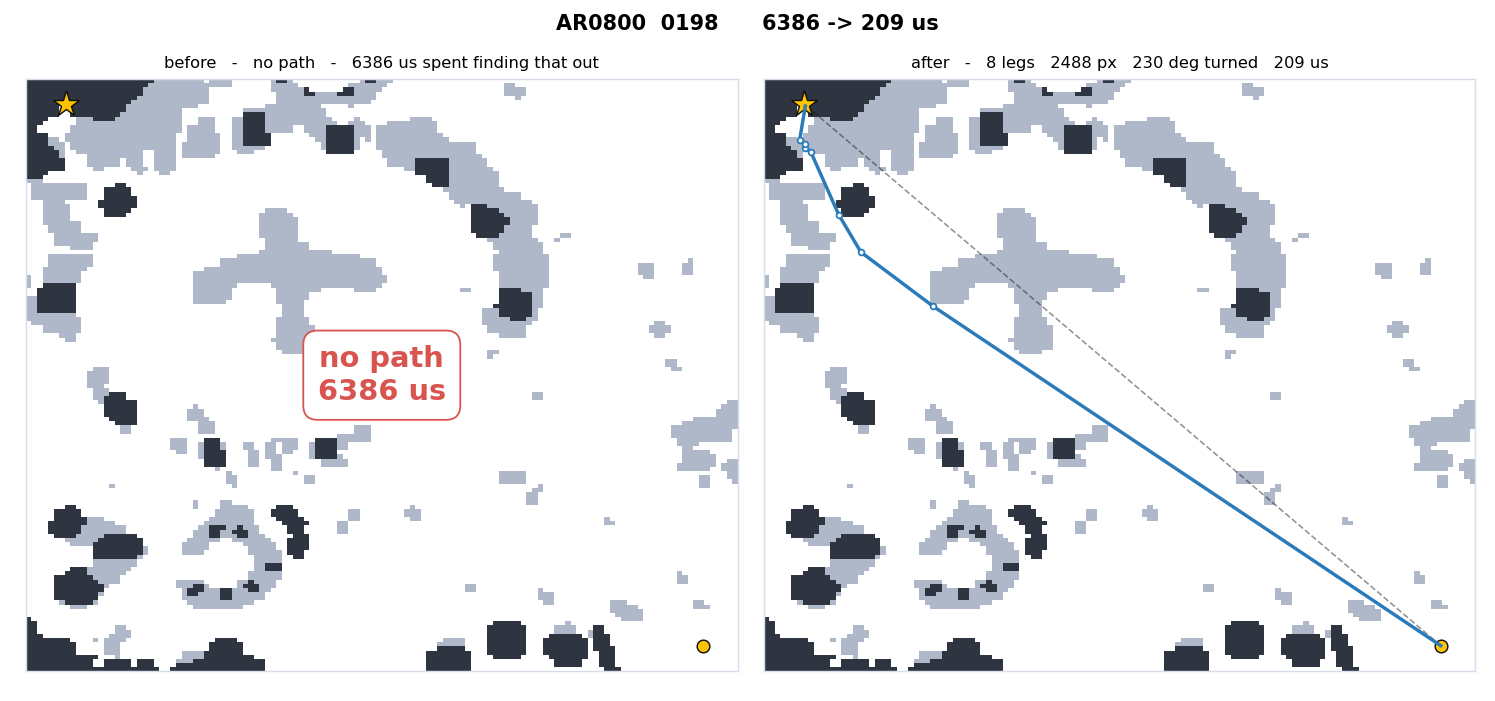
ar0800_0198
AR0800 ar0800_0198 - 6386 -> 209 us
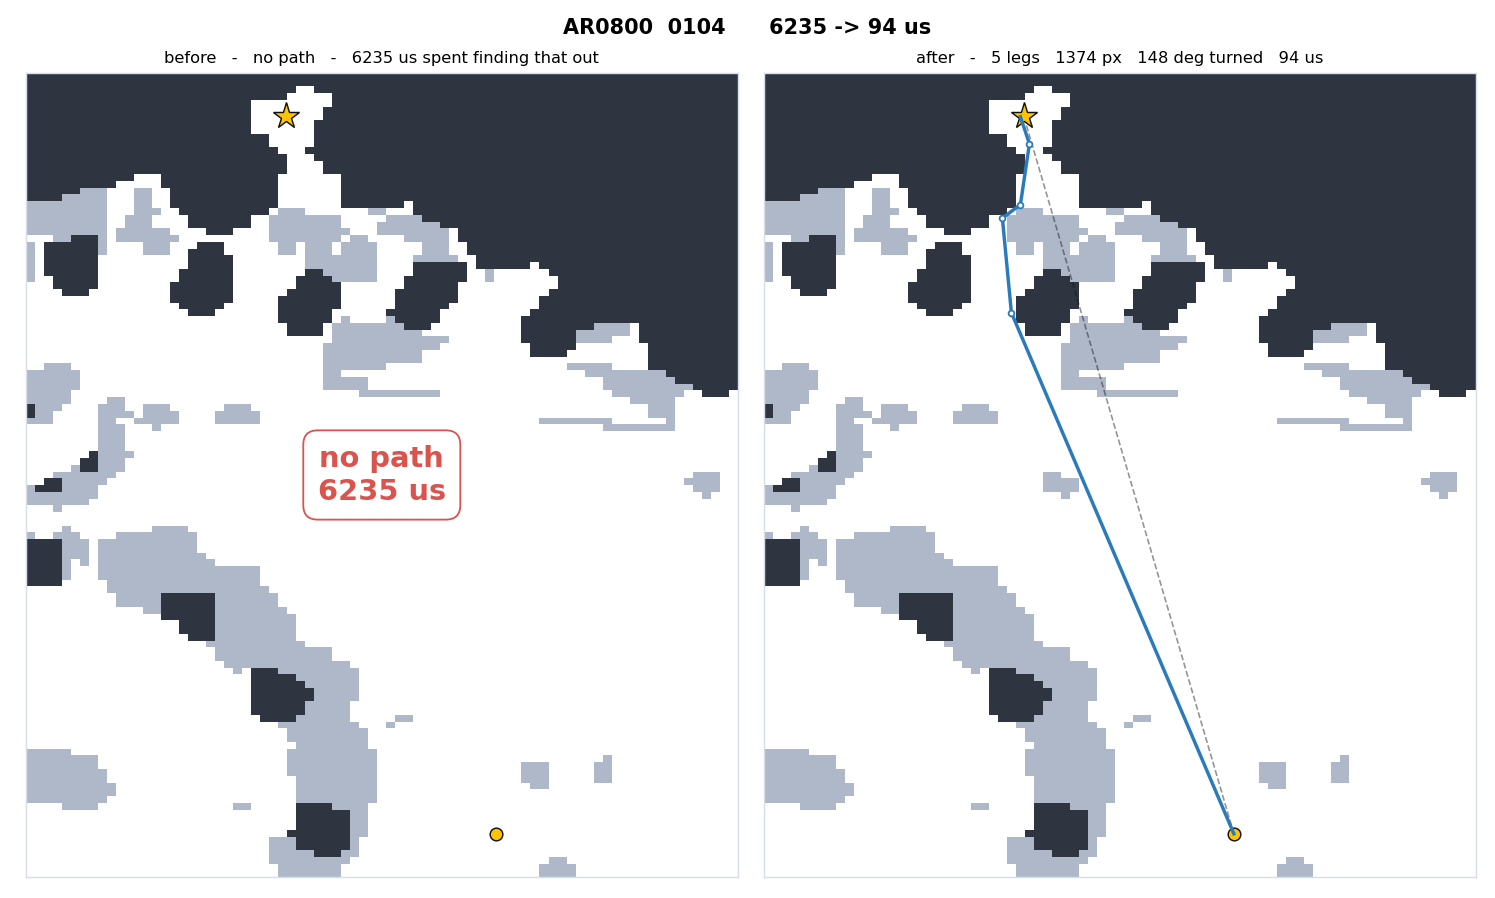
ar0800_0104
AR0800 ar0800_0104 - 6235 -> 94 us
ar0800_0109
AR0800 ar0800_0109 - 6302 -> 330 us
ar0800_0008
AR0800 ar0800_0008 - 6045 -> 161 us
ar0400_0196
AR0400 ar0400_0196 - 12384 -> 6753 us
ar3400_0270
AR3400 ar3400_0270 - 6285 -> 676 us
ar3400_0299
AR3400 ar3400_0299 - 6414 -> 829 us
ar0400_0274
AR0400 ar0400_0274 - 6252 -> 670 us
ar0400_0258
AR0400 ar0400_0258 - 3178 -> 440 us
ar0400_0137
AR0400 ar0400_0137 - 2975 -> 461 us
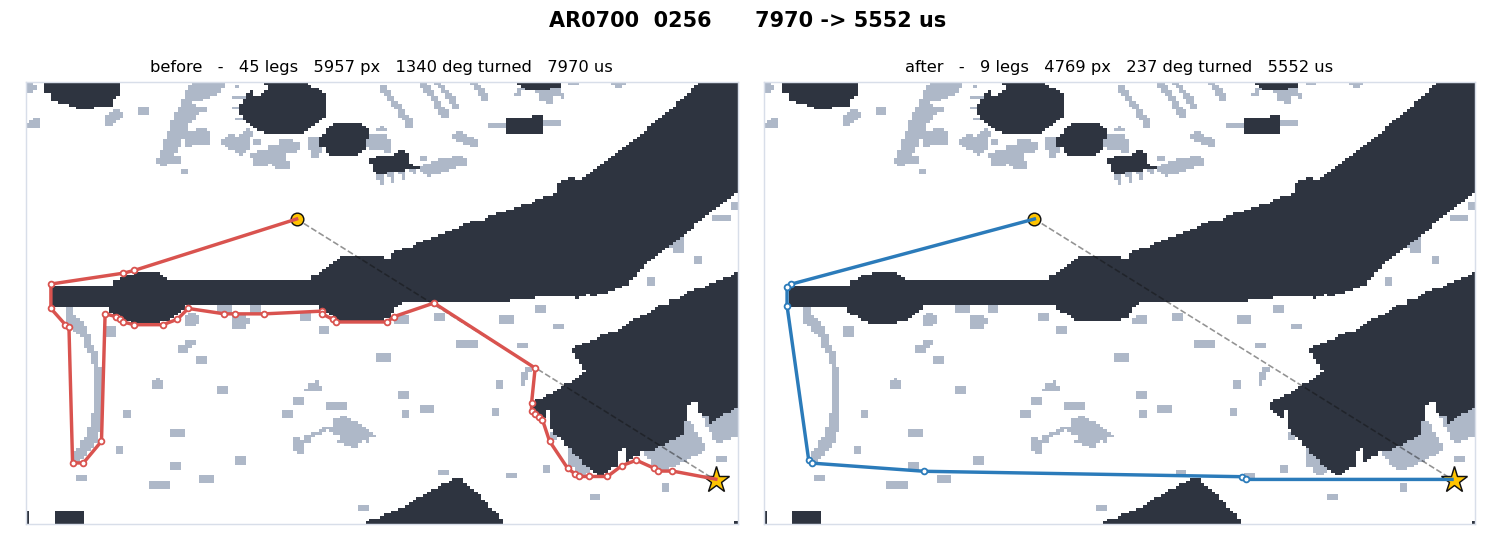
ar0700_0256
AR0700 ar0700_0256 - 7970 -> 5552 us
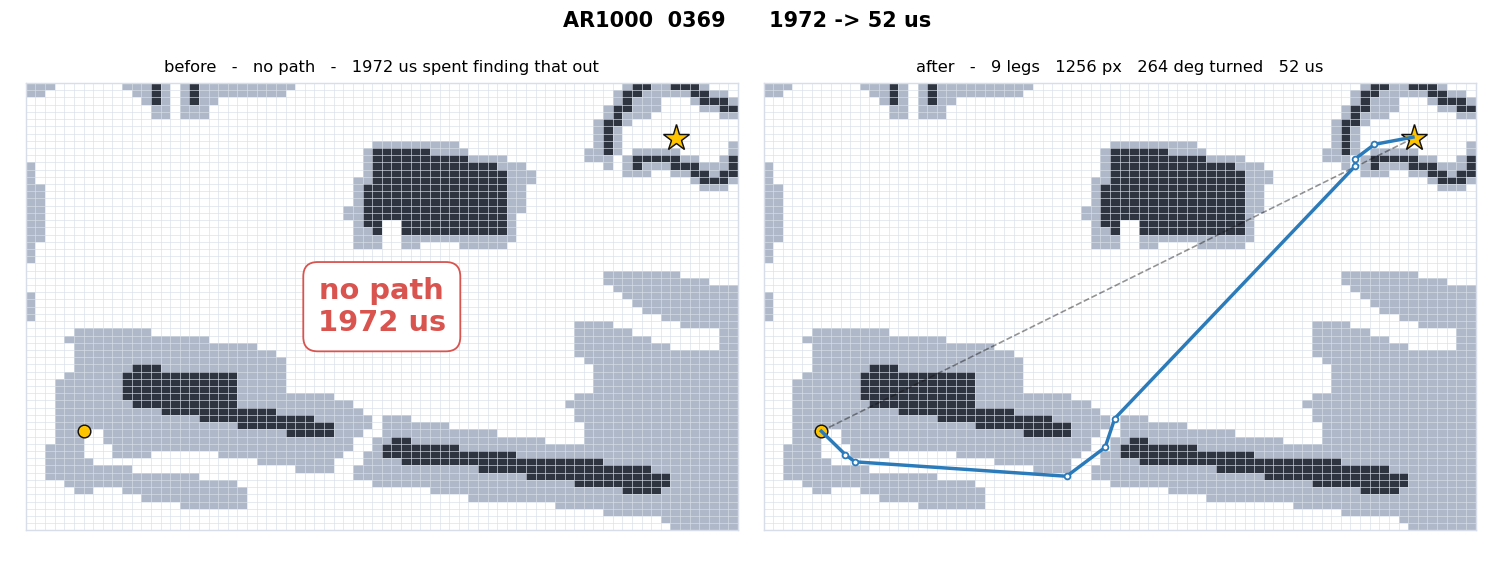
ar1000_0369
AR1000 ar1000_0369 - 1972 -> 52 us
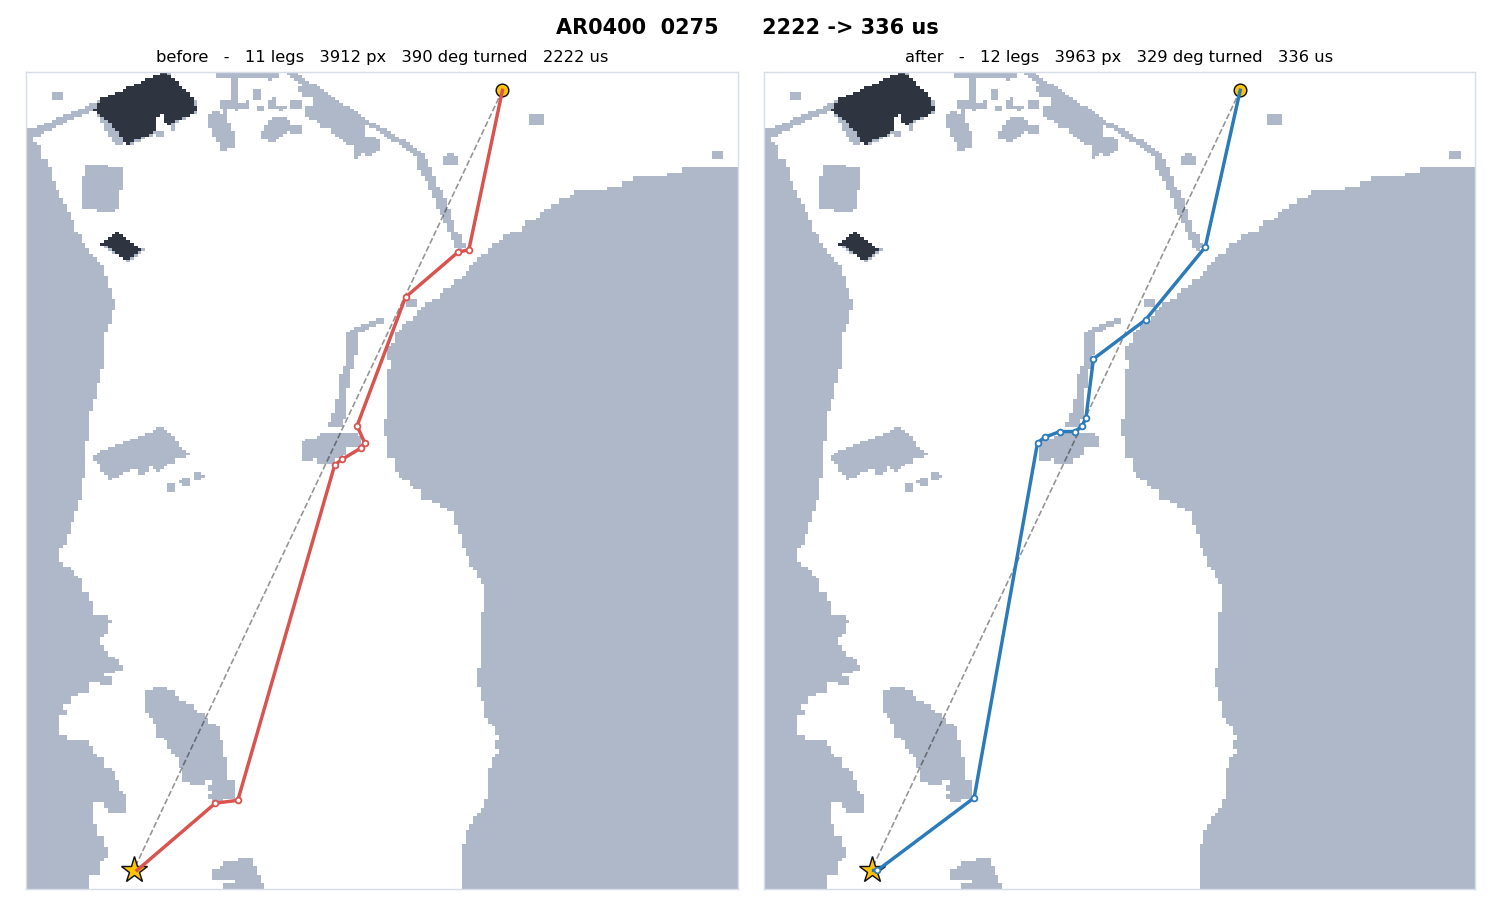
ar0400_0275
AR0400 ar0400_0275 - 2222 -> 336 us
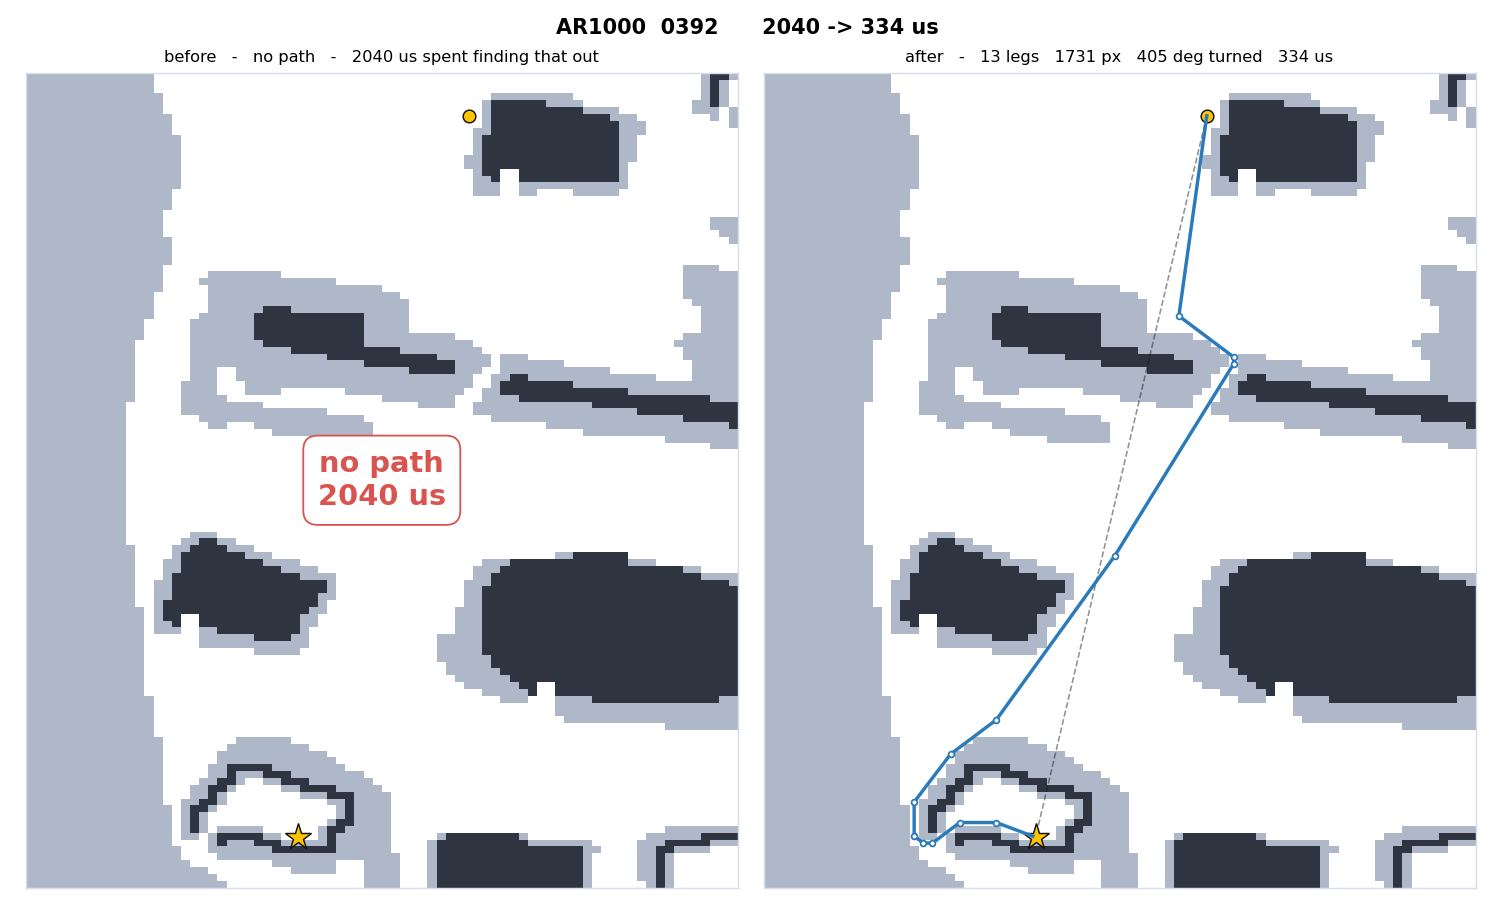
ar1000_0392
AR1000 ar1000_0392 - 2040 -> 334 us
ar0400_0211
AR0400 ar0400_0211 - 3371 -> 1764 us
ar0700_0019
AR0700 ar0700_0019 - 1963 -> 441 us
ar0700_0345
AR0700 ar0700_0345 - 2147 -> 669 us
ar0403_0370
AR0403 ar0403_0370 - 1533 -> 141 us
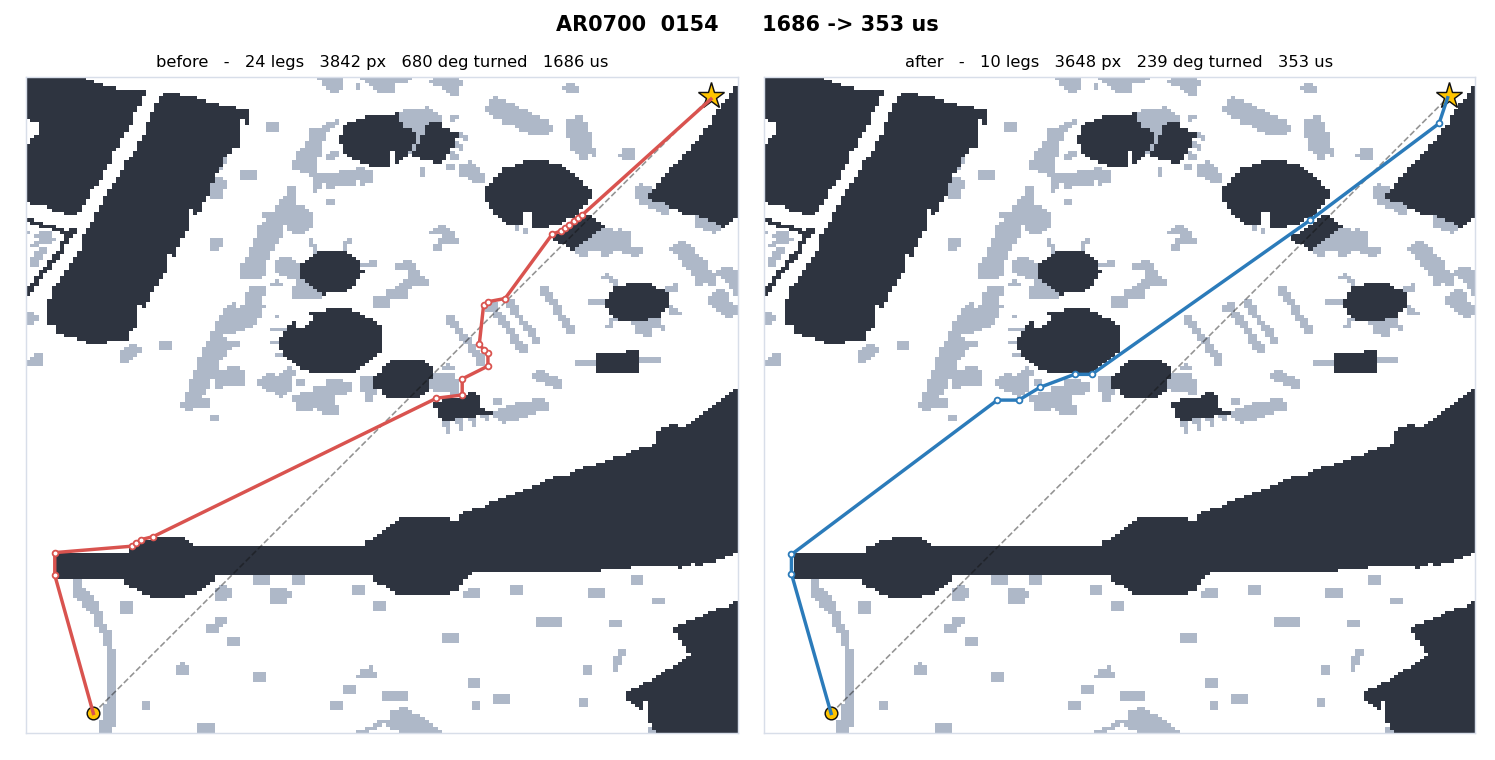
ar0700_0154
AR0700 ar0700_0154 - 1686 -> 353 us
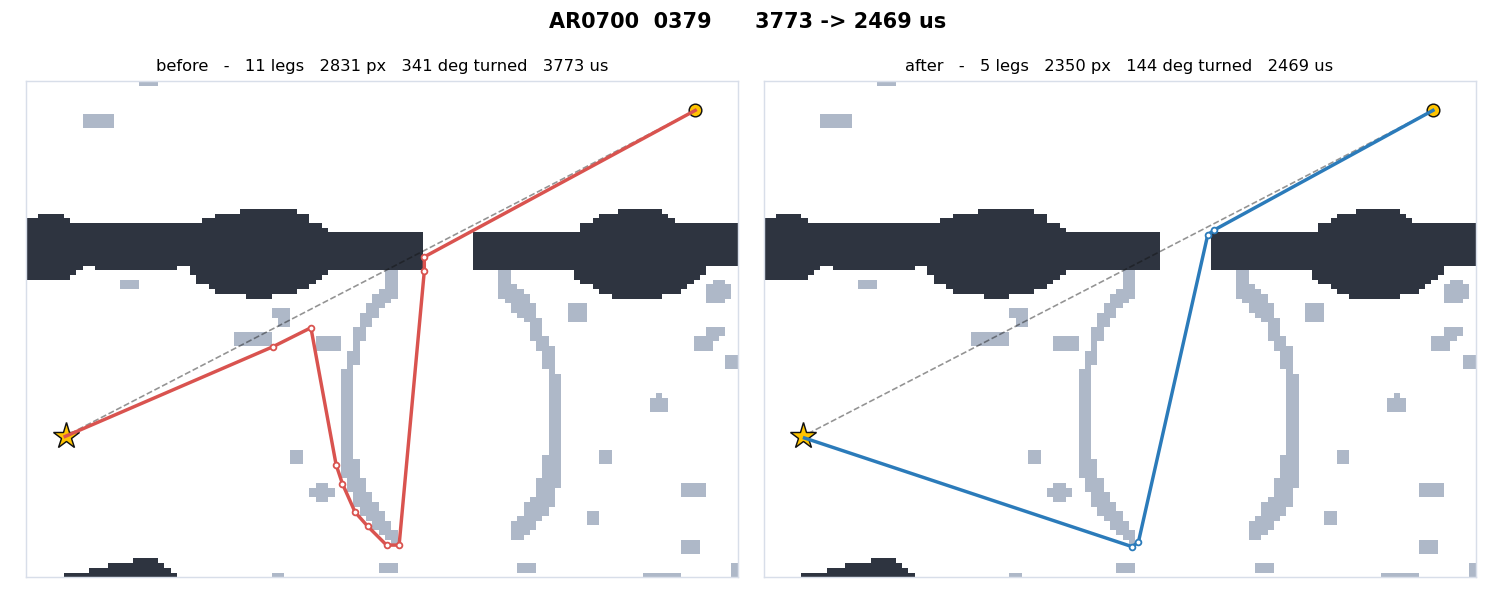
ar0700_0379
AR0700 ar0700_0379 - 3773 -> 2469 us